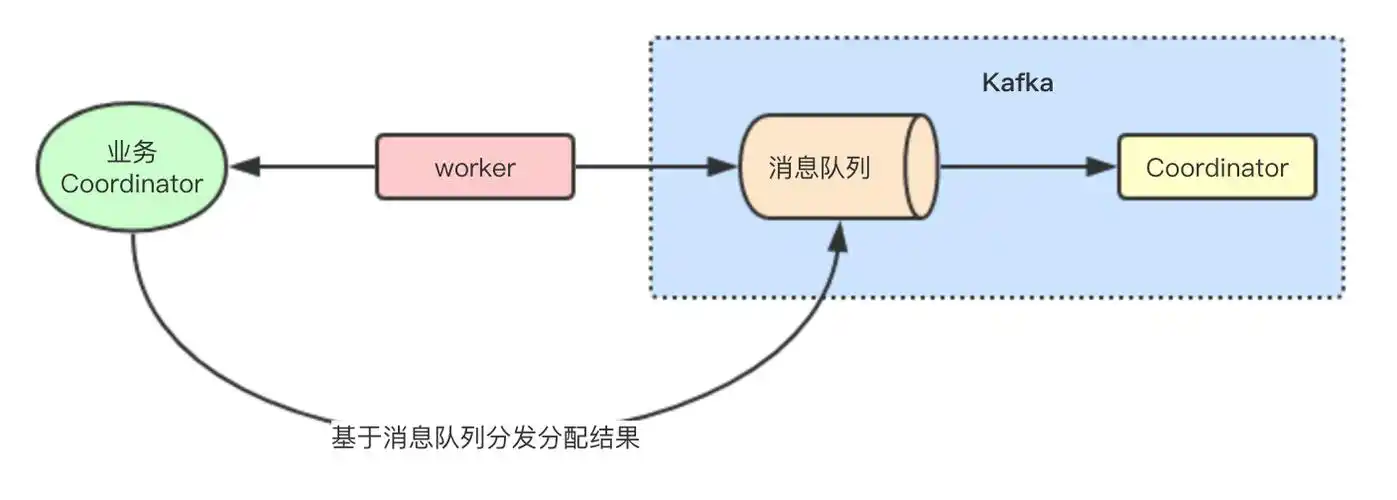
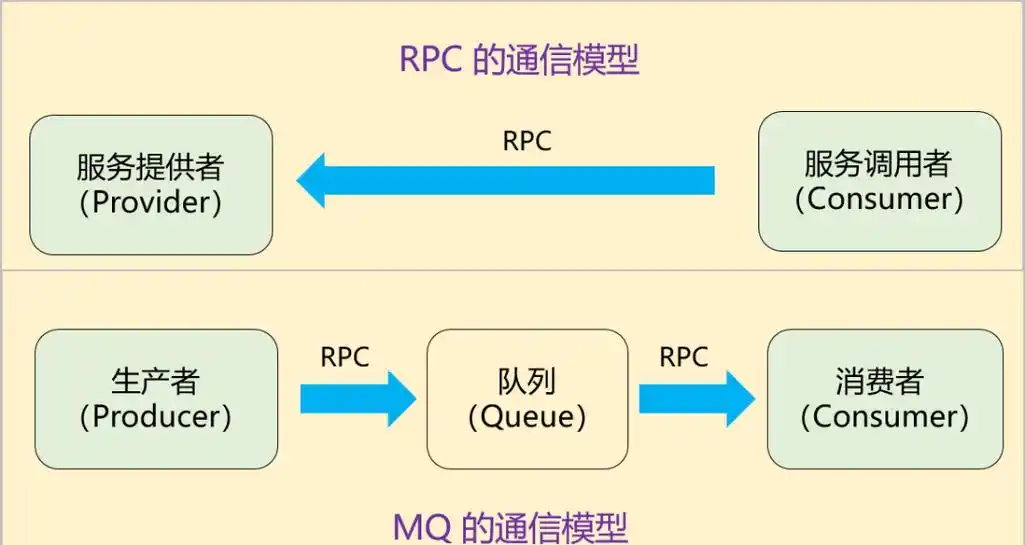
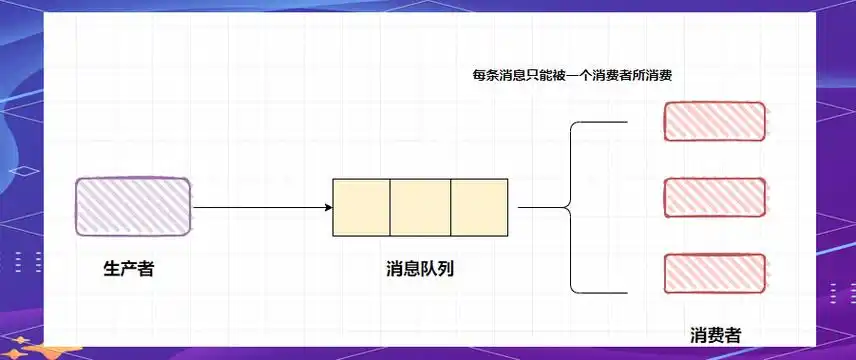
判断该用任务队列还是消息队列,最省事的办法是先问一句:这条东西是“一件要被执行完的事”,还是“一条要告诉很多人的事实”。前者要有人接手、有成功失败、有重试和结果可查,通常落在任务队列(Celery、Sidekiq、RQ、Bull 这类 worker 模型)上;后者只关心“发出去了、谁需要谁订阅”,通常落在消息队列或消息中间件(Kafka、RabbitMQ、RocketMQ 这一类)上。两者都能“异步”,但责任边界不同:任务队列把执行状态揽在自己身上,消息队列只保证投递与消费位点,业务状态要你自己存。
如果你的下游只有一个执行者、需要看到“这条任务完成没有、失败几次、什么时候重试”,优先用任务队列,把状态表和幂等键放在业务侧;如果是多个服务或多套逻辑要同时知道同一件事、需要削峰或回放历史,优先用消息队列,由消费组各自维护位点。判断依据是消费方数量、是否需要执行结果、是否要回放,不是吞吐数字。选完必须验证:重复投递是否幂等、进程崩溃后任务是否被重新拾起、失败是否可查。反过来的用法也能跑,但重试、状态、死信都要自己补,代价要提前认。
先确认当前场景和目标
先把要异步化的那段逻辑写下来,标注清楚:谁产生、谁消费、消费失败之后谁负责、有没有人需要查询“做完了没有”。这一步没写清楚,后面选什么组件都容易反复。
建议按下面几条逐项确认,只要有一条命中右侧,方向就基本定了:
- 消费方只有一个明确的执行者,且业务方要查询执行结果或失败原因 → 任务队列。
- 同一件事需要被订单、通知、统计等多个下游各自处理 → 消息队列(一个 topic,多个消费组)。
- 需要延迟执行、定时执行、按时间窗口重试(例如 5 分钟后重发短信) → 任务队列更顺手。
- 需要事后重放一段历史数据来修数或补算 → 消息队列的位点/保留策略更合适。
- 短时间大量请求涌入,需要先缓冲再慢慢处理 → 两者都能削峰,但要先确认是否有顺序要求和单条处理耗时。
- 失败后希望自动重试若干次、超过次数进死信并可人工重跑 → 任务队列自带,消息队列通常要自己搭。
还要确认两个容易被跳过的前提:一是任务是否可重入,同一条消息被投递两次会不会重复扣款或重复发券;二是单条处理耗时大概在什么量级,超过中间件默认的可见性超时或 ack 超时,就会出现“还在跑但已被重新投递”的假重复。
按这个顺序处理
顺序上建议先定责任边界,再选组件,最后补可靠性,不要反过来先挑中间件。
- 先画消费方拓扑。 把产生方和所有消费方画出来。只有一个执行者,倾向任务队列;出现第二条独立的消费链路,就要按消息队列的模型设计,否则以后加一个下游就得复制一份任务。
- 判断这是“动作”还是“事实”。 “生成报表”是动作,有完成态;“订单已支付”是事实,可以被多方订阅。动作放任务队列,事实放消息队列,这是最稳的切法。
- 决定状态存在哪。 用任务队列时,别把执行结果只放在队列的结果后端里,业务侧建一张任务表(任务 ID、业务键、状态、重试次数、最后错误、更新时间)更可控;用消息队列时,消费位点和业务状态要分开想,位点提交了不等于业务成功。
- 补幂等和重试。 无论选哪个,都以“至少一次投递”为前提设计。用业务唯一键做幂等,重试次数与退避策略写成配置,不要写在硬编码里。
- 留死信和可观测入口。 失败超过阈值的任务或消息要能落到可查询的地方,并带原始载荷和错误原因,否则线上出问题只能猜。
- 先小流量接入。 挑一个非核心链路先跑,确认重复、崩溃、超时三种情况的表现,再扩大范围。
下面是通用接入骨架,只表达“任务队列”和“消息队列”两种写法在代码层面的差别,字段和调用名按你所选组件替换,不要照抄成某个 SDK 的官方用法:
# 方式一:任务队列(动作型,有执行状态)
# 任务表先落库,再投递,worker 只按 task_id 取任务执行
task = create_task(biz_key="order:123:export", status="pending")
enqueue("export_order", args=[task.id], max_retries=3, countdown=60)

def export_order(task_id):
    task = load_task(task_id)
    if task.status == "done":        # 幂等闸门
        return
    do_export(task.biz_key)
    mark_done(task_id)

# 方式二:消息队列(事实型,多方订阅)
publish(topic="order.paid", key="order:123", payload={"order_id": "123", "paid_at": "..."})

# 各消费组独立消费,各自保证幂等
consumer_group("notify").on("order.paid", handler=send_paid_sms)
consumer_group("stats").on("order.paid", handler=incr_paid_counter)  # 用 order_id 去重
这段骨架的两个关键点:任务队列写法里,先落任务表再投递,worker 只按 ID 取任务,重复投递会被状态挡掉;消息队列写法里,幂等放在每个消费组内部,按业务键去重,而不是指望中间件只投一次。
改完后怎么验证
验证不要只看“跑通了”,要看异常路径是否按设计收敛。可以在测试环境人为制造下面几种情况,逐项观察:
- 重复投递: 手动把同一条任务或消息投两次,预期业务只产生一次效果,任务表里状态一致,消费侧没有多出来的记录。
- 进程中断: 在 worker 执行到一半时杀掉进程,预期任务在一段时间后被重新拾起(或进入失败可查状态),不会永久停在“执行中”。
- 失败重试: 让处理逻辑故意抛错,预期按配置的次数和间隔重试,超过阈值后进入死信或失败状态,且能从任务表或死信队列里查到原始载荷和错误信息。
- 延迟与定时: 设一个短延迟或定时任务,确认实际触发时间在预期范围内,没有提前执行或长期不触发。
- 堆积: 短时间灌入一批任务,观察消费是否持续前进、延迟是否回落;如果延迟只增不减,先看单条处理耗时和并发数,而不是急着换中间件。
预期信号是:任务或消息的最终状态与业务数据一致,失败项可定位、可重跑,重复投递不产生重复业务效果。只要这三点成立,选型方向基本可用;如果“执行中”状态会长期悬挂,先查可见性超时或 ack 超时设置,而不是业务逻辑。
容易忽略的边界
几个常见坑,选型时就要写进约束里:
- 长任务撞上超时: 单条耗时超过可见性超时或 ack 超时,会出现同一条任务被多个 worker 同时执行。长任务要么拆小,要么在处理过程中续期心跳,要么改由任务表驱动、队列只做唤醒。
- “恰好一次”不现实: 按至少一次投递设计,幂等靠业务键。没有唯一业务键的场景,先造一个(请求 ID、业务单号),别指望中间件配置能解决。
- 把消息队列当调度器: 用消息队列做定时和重试,需要自己维护延迟表或定时扫描,复杂度和出错面都会上升;这类需求更适合任务队列。
- 把任务队列当事件总线: 每加一个下游就要加一份任务逻辑,容易漏发、难以重放,多人订阅同一事实时还是用消息队列。
- 顺序性: 需要严格按业务键有序时,确认分区键或路由键的设置,并接受“有序”通常意味着同一键串行、吞吐受限。
- 存储与持久化: 用内存型存储做队列中转时,要确认持久化配置和重启后的数据可见性,关键任务建议先落库再投递,队列丢了还能从任务表补投。
- 回退方案: 上线前保留开关,出问题能切回同步处理或双写;已经投递但处理异常的任务,用任务表或死信做补偿重跑,不要直接清空队列。
如果现有环境只有一个执行者、也没有多下游订阅的规划,先用任务队列跑通,把任务表和幂等键做好,后续真的出现多方订阅再引入消息队列,迁移成本通常比一开始就上事件流要低。