量化后的显存不能按“参数量 × 0.5 字节”一句话算完。相对可靠的算法是把显存分成三块:权重文件本身、KV cache、框架与硬件的固定开销,再乘上并行切分和余量的影响。真正决定能不能跑起来的,往往不是权重那部分,而是 KV cache 和运行时开销——7B 模型 INT4 权重只占几个 GB,但把上下文拉到 32K、并发开到 8 时,KV cache 会变成主要占用。所以估算的第一步不是套公式,而是先确认你要回答的是“能不能在这张卡上跑通”,还是“按目标并发和上下文该选多大显存”。
量化模型显存估算建议按“权重 + KV cache + 运行时开销”三段做,权重部分优先用实际权重文件总大小做校验,不要只按位宽理论值推算;KV cache 由层数、KV 头数、head_dim、上下文长度和批大小共同决定,通常是长上下文场景的瓶颈。估算结果用于选卡和定并发上限,最终以逐步加压观测到的实际占用为准,并保留一定余量应对碎片和临时 workspace。
先确认当前场景和目标
同一句“量化后占多少显存”,在不同场景下的答案差别很大。动手前建议先把下面几项信息确认清楚,缺一项,估算结果就可能偏差一个量级。
- 量化方式:是仅权重量化(W4A16、W8A16 这类),还是权重与激活都量化。仅权重量化时激活仍按 FP16 计算,运行时开销不能按 INT4 估算。
- 权重哪些层被量化:embedding、lm_head、LayerNorm 通常保持高精度,参数量占比不小,估算时要单独加上。
- 上下文长度与并发:单条请求 4K 和批量 16 条 32K,KV cache 差几十倍。没有明确的 seq_len 和 batch,估算就没有意义。
- 卡数与并行策略:张量并行能把权重和 KV cache 分摊到多卡,但每张卡都要付一份框架和 CUDA context 开销。
- 推理框架:是否启用 PagedAttention、前缀缓存、chunked prefill,这些会明显改变峰值占用。
判断标准可以先粗略定:如果只是想在本机跑通一次对话,按实测空载占用加宽松余量即可;如果要做容量规划、决定买几张卡或给线上服务定最大并发,就必须逐项算清楚,并且用实际权重文件大小反查权重估算是否可靠。
按这个顺序处理
第一步:用权重文件大小定权重部分。这是最不容易出错的做法。直接看模型目录下所有 safetensors 或 bin 文件的总大小:
du -ch /path/to/model/*.safetensors | tail -n 1
du -sh /path/to/model
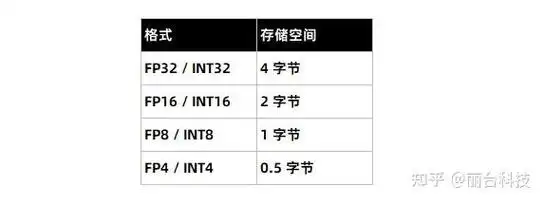
这个数值就是加载权重所需显存的下限(加载瞬间可能因内存拷贝出现短时峰值)。如果拿不到文件,再用“参数量 × 每参数字节数”估算:FP16 约 2 字节/参数,INT8 约 1 字节/参数,INT4 名义 0.5 字节/参数,但要额外考虑量化 scale、zero-point 以及未量化层的开销,实际会高于 0.5。用文件大小和公式互相校验,差异过大时以文件大小为准。
第二步:单独算 KV cache。公式是 2 × 层数 × KV 头数 × head_dim × 序列长度 × 批大小 × 每元素字节数。注意用 KV 头数而不是总头数,GQA 模型这里差距很大。
def est_vram_gb(weight_files_gb, n_layers, n_kv_heads, head_dim,
                seq_len, batch, kv_bytes=2, overhead_gb=1.5, tp=1):
    kv = 2 * n_layers * n_kv_heads * head_dim * seq_len * batch * kv_bytes / 1024**3
    per_gpu = weight_files_gb / tp + kv / tp + overhead_gb
    return {'weight': round(weight_files_gb, 2),
            'kv_cache': round(kv, 2),
            'per_gpu_total': round(per_gpu, 2)}

# 示例调用,参数请替换成自己模型的 config.json 里的值
print(est_vram_gb(weight_files_gb=4.2, n_layers=32, n_kv_heads=8,
head_dim=128, seq_len=8192, batch=4, tp=1))第三步:补运行时开销。CUDA context、框架自身的显存池、临时激活、量化 kernel 的 workspace、显存碎片,通常合计在 1~2 GB 量级,长输入 prefill 阶段还会更高。建议先用一个空载进程实测一份基线,再把这个基线作为 overhead_gb 填进去,比拍脑袋取值可靠。
第四步:留余量并反推并发上限。把权重和 KV cache 相加后,再预留一部分空间应对碎片和峰值;如果结果贴着显卡容量,实际运行时很容易在长请求上 OOM。反过来,也可以用已知显存减去权重和开销,再除以单条请求的 KV 占用,得到大致可支撑的并发数。
改完后怎么验证
估算只是纸面数字,验证要落到实际占用上,建议按下面的顺序做:
- 先加载模型但不发请求,记录空载显存。这个值与“权重 + 固定开销”的估算对比,差得多说明 overhead_gb 取值偏小或框架有额外占用。
- 发一条短请求,记录占用增量;再把输入长度逐步加长到目标上下文,观察 KV cache 增长速度是否与公式趋势一致。
- 逐步提高并发,找到出现 OOM 或明显变慢的临界点。临界并发与估算值相差较大时,优先检查是否开启了前缀缓存、PagedAttention 等会改变 KV 占用形态的特性。
- 用
nvidia-smi或nvidia-smi --query-gpu=memory.used --format=csv -l 1持续观察,重点看 prefill 阶段的峰值而不是稳态值。
除了显存,还要确认量化没有把效果搞坏:准备一小组有代表性的输入,对比量化前后的输出,尤其是长上下文检索、数字和代码类任务。显存省下来了但输出明显退化,说明量化方案不适合当前任务,需要换精度或换量化方法。
容易忽略的边界
- 并行切分不是线性缩放:张量并行下权重按维度切分,若某层维度不能被卡数整除,或 KV 头数少于卡数,切分后可能出现负载不均,单卡占用高于平均值。
- 加载峰值高于稳态:从磁盘读权重、格式转换、多份拷贝同时存在的瞬间,占用可能明显高于运行时的稳态值,多卡场景尤其要留意每张卡各自的加载过程。
- 共享与受限环境:MIG 切分、共享 GPU、显存被其他进程占用时,可用容量不等于卡标称容量,估算前先确认真实可用显存。
- CPU offload 不算显存方案:把部分层放到内存能降低显存占用,但会带来明显的速度下降,适合验证和调试,不适合作为容量规划的默认假设。
- 版本差异:不同推理框架对同一量化格式的支持程度和显存策略不同,估算结果需要结合具体框架版本确认;换框架或升级版本后建议重新跑一遍上面的验证步骤。
如果估算结果与实测长期对不上,回退建议是:先用实测空载占用加目标 KV cache 反推,而不是继续调公式参数;无法在目标显存内满足上下文和并发要求时,优先考虑缩短上下文、降低并发或增加卡数,而不是依赖 offload 硬扛。