搜「大模型本地部署怎么弄的」的人,多数不是缺教程,而是卡在三个具体处:不知道自己手上这台机器的显卡能不能用、不知道下载的权重该放哪、不知道启动命令跑起来后怎么判断是成功了还是只是没报错。本地部署的最小闭环其实是「确认真实可用资源 → 拿到权重 → 起一个推理服务 → 用一次真实请求验证」,四步之外的东西都可以后补。下面按排查顺序写,命令和路径写完整,能复制就先复制。
本地部署大模型的判断顺序是:先确认显卡驱动与显存、磁盘余量、模型下载权限这三项前提,再走「装运行环境 → 拉权重 → 起服务 → 发一次请求」的最短路径。适用于单机、单卡或少量并发自用场景;如果是多人共用或多卡并行,需要先确认框架对多卡的支持方式。验证方式不是看进程有没有起来,而是发一条带明确输出的请求并拿到完整回复。风险边界:显存不足时模型会直接加载失败或被系统杀掉,不要用交换分区硬撑;权重许可、商用条款要先看清模型卡上的说明。
大模型本地部署之前先确认这三件事
这三件事任意一项没确认,后面都会卡在看起来无关的地方。
一、显卡与驱动版本。在 Linux 上执行:
nvidia-smi看两个字段:右上角的 Driver Version,以及下方表格里的 Memory-Total。前者决定你能装的推理框架版本,后者决定你能加载多大的模型。如果提示 NVIDIA-SMI has failed because it couldn't communicate with the NVIDIA driver,说明驱动没装好或内核升级后模块没重建,先解决驱动,别急着装框架。没有独显的机器可以走 CPU 推理,但速度和可用模型规模会明显受限,需要先有心理预期。
二、磁盘余量。执行:
df -h看权重所在分区的 Avail 列。模型权重、推理框架缓存、量化版本文件加起来会占不少空间,同一模型的不同量化版本往往是各自独立的文件,不能共享。权重目录建议单独放一块大盘,不要塞在根分区里。
三、下载权限与入口位置。多数权重托管在 Hugging Face 或 ModelScope 这类站点。需要确认:能否正常访问该站点、是否有该模型的访问许可(部分模型需要在模型页面上点击同意条款)、本机是否配置了访问令牌。在 Hugging Face 上的位置是模型页面的 Files and versions 标签,以及账号设置里的 Access Tokens 页面。ModelScope 对应的是模型页的「模型文件」页签和「个人中心 - 访问令牌」。这一步的判断方法很直接:用浏览器或 curl -I 请求一下模型页面,能拿到 200 再继续。
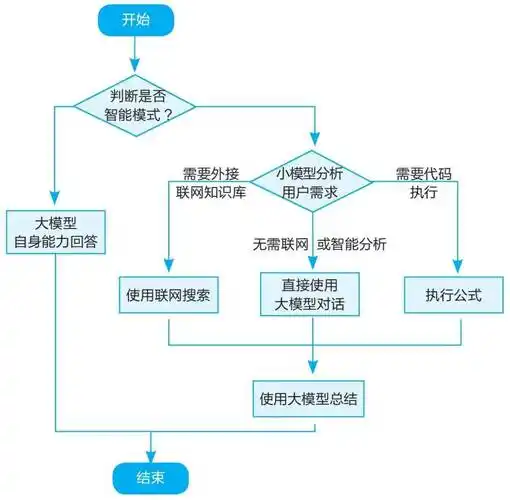
大模型本地部署:最短可用路径
只保留四步,每步做完都有一个可观察的结果,不确定就先停在这一步。
第 1 步:建独立环境。
python3 -m venv ~/llm-env
source ~/llm-env/bin/activate
python -V
看到 Python 版本号输出即成功。建议用 Python 3.10 或 3.11 这类主流版本,太新的版本常常还没有预编译的推理依赖。
第 2 步:装推理框架。以常见的 vLLM 为例:
pip install -U pip
pip install vllm
装完执行 python -c "import vllm; print(vllm.__version__)",能打印出版本号即成功。版本号一定要记下来,后面报错排查时要对照框架自身的文档版本。如果这一步编译报错,多半是 CUDA 工具链版本和框架要求不匹配,去框架的 PyPI 页面或 GitHub Releases 看它标注的 CUDA 版本。
第 3 步:把权重下到本地。先设令牌,再下载:
export HF_TOKEN=你的令牌
huggingface-cli download 模型仓库名 --local-dir ~/models/模型名
把「模型仓库名」换成模型页面上的完整 ID,格式通常是 组织名/模型名。下载完成后 ls ~/models/模型名 应能看到 config.json、tokenizer.json 和若干 .safetensors 文件。缺 config.json 说明下载不完整,重新执行下载命令它会续传。
第 4 步:起服务并发一次真实请求。启动:
python -m vllm.entrypoints.openai.api_server \\
  --model ~/models/模型名 \\
  --served-model-name local-model \\
  --host 127.0.0.1 \\
  --port 8000
另开一个终端验证:
curl http://127.0.0.1:8000/v1/chat/completions \\
  -H "Content-Type: application/json" \\
  -d '{"model":"local-model","messages":[{"role":"user","content":"用一句话说明什么是张量"}],"max_tokens":64}'
看到返回 JSON 里 choices[0].message.content 有完整中文句子,才算真正跑通。只看到服务打印出监听地址不算,那只是进程活着。
大模型本地部署:一个真实场景的完整做法
场景设定:一台单卡机器,显存 24GB,要给内部几个人提供一个能读本地文档的问答入口,文档是一批 PDF 和 Word,总量在几百份量级,单次问答带 3 到 5 段检索片段做上下文。这个场景的关键约束是显存,因为上下文越长,KV 缓存占用越大。
起步阶段先用 7B 到 8B 级别的指令模型,不要一上来就选 70B。对应的启动参数调整为:
python -m vllm.entrypoints.openai.api_server \\
  --model ~/models/模型名 \\
  --served-model-name local-model \\
  --host 0.0.0.0 \\
  --port 8000 \\
  --max-model-len 8192 \\
--gpu-memory-utilization 0.85三个参数分别在哪改、为什么这么取:--max-model-len 控制单次上下文上限,8192 足够覆盖几段检索片段加回答,取值过大在 24GB 卡上会直接触发 KV 缓存不足;--gpu-memory-utilization 是框架可占用显存的比例,留出余量给别的进程,0.85 是保守起点;--host 0.0.0.0 是为了让同网段的人能访问,只自用就改回 127.0.0.1。
文档侧的准备不在推理服务里做,通常用独立的检索工具把文档切块、向量化,检索出片段后拼进提示词再调用上面的接口。检索工具的配置放在它自己的配置文件里,与推理服务的启动参数是两套东西,不要混在一个文件里改。
这个场景的落地顺序建议:先只跑通一次带长提示词的请求,确认 8192 上下文在目标显存下稳定,再接检索链路。顺序反了的话,出问题时你分不清是检索没召回到内容,还是模型没加载成功。
大模型本地部署:跑不通先查这三处
卡点一:显存不足。最常见的报错是框架提示 torch.OutOfMemoryError: CUDA out of memory,或者提示 No available memory for the cache blocks。判断方法:先在服务没启动的状态下跑一次 nvidia-smi,看 Memory-Used 是否已经有别的进程占着;再确认 --max-model-len 和 --gpu-memory-utilization 是不是设得太大。降上下文长度、换更小的量化版本、关掉同卡上的其他进程,这三条按代价从低到高试。不要用系统交换分区去顶,那只会让速度变得没法用。
卡点二:权重加载失败。典型提示是 OSError: 模型路径 does not appear to have a file named config.json,或者报某个 .safetensors 文件缺失、大小不符。判断方法:进到权重目录执行 ls -lh,核对文件列表是否和模型页面 Files and versions 里的一致;再看下载命令有没有中途被打断。这类问题基本都能靠删掉不完整的分片文件后重新执行下载命令解决,下载工具会跳过已完整的文件。
卡点三:请求能通但返回空或报 404。页面上表现为 curl 返回 {"detail":"Not Found"},或返回里 content 是空的。判断方法:404 先看请求路径,OpenAI 兼容接口的路径是 /v1/chat/completions,少写 /v1 或拼错就会 404;再看请求体里的 model 字段是否和启动时 --served-model-name 完全一致,大小写不同也会匹配失败。返回空内容则检查 max_tokens 是否设得过小、提示词是否被截断。这两种都能用一条最简请求复现,不用翻服务日志。
这三处排查完仍不通时,再去翻服务端日志的完整堆栈;先看堆栈最后一行报错原文,再回查上面三类,比从头读日志快。