接口超时先别改代码,先判断超时发生在哪个环节:客户端、网络链路、网关/负载均衡、应用服务、下游依赖,还是数据库或缓存。同一个“超时”报错,落点不同,处理方式完全相反。下面按真实排查顺序给出可执行的检查位置、确认动作和回滚办法,命令和路径都写到能直接复制或照着找。
接口超时的排查顺序建议是:先看客户端报错原文和耗时分布,再在服务端确认请求是否到达、卡在哪一段,最后才动配置或代码。判断依据是“请求有没有进来、进来后停在哪一步”,不要凭报错关键字直接改超时时间。调大超时属于止血,不是修复;改完需要用同一路径复测并观察一段时间,同时准备好回滚原配置。
接口超时先定位在哪一层
先建立一条链路地图:客户端 → DNS/网络 → 网关或负载均衡 → 应用服务 → 下游服务/数据库/缓存。超时报错只说明“等待超过了阈值”,不说明是谁慢。需要结合环境确认请求实际走到了哪一层。
每一层的检查位置和判断依据如下:
- 客户端层:看报错类型是连接超时(connect timeout)还是读取超时(read timeout)。连接超时通常指向网络或目标不可达;读取超时通常指向服务端处理慢。同时看客户端耗时分布,是所有请求都慢还是个别请求慢。
- 网络与 DNS 层:在客户端机器执行
curl -o /dev/null -s -w 'dns:%{time_namelookup} connect:%{time_connect} tls:%{time_appconnect} first_byte:%{time_starttransfer} total:%{time_total}\n' https://你的接口地址,用分段耗时判断慢在解析、建连还是首字节。 - 网关/负载均衡层:看网关访问日志里该请求的状态码、上游响应时间(upstream_response_time)和请求总时间(request_time)。两者差很大,说明慢在网关到上游之间或上游本身;网关直接返回 504,说明上游没在网关超时前响应。
- 应用服务层:确认请求是否到达应用。看应用访问日志里有没有对应 trace id 或请求路径,有记录说明已进入应用,没有则卡在前面某一层。
- 下游依赖与存储层:应用日志里如果出现下游调用耗时、连接池等待、SQL 执行时间,先把最慢的那一段挑出来,再决定是查数据库、缓存还是第三方接口。
判断原则:报错发生在客户端,不代表故障在客户端。只有请求在服务端留下痕迹,才说明问题进入应用内部;否则优先排查网络、网关和上游可达性。
接口超时:先看这四个位置
这四个位置按顺序看,能快速把范围缩小到一两个环节。
1. 客户端报错原文与耗时
保留完整报错,不要只留“timeout”。用上面的 curl 分段耗时命令复现一次,记录 dns、connect、first_byte、total 四个值。若 first_byte 很大而 connect 很小,重点转向服务端处理;若 connect 就超时,重点查网络和端口。
2. 网关或反向代理的访问日志
常见位置是 /var/log/nginx/access.log 或网关自身的日志检索页面。用请求路径过滤,例如 grep '你的接口路径' /var/log/nginx/access.log | tail -n 50。重点看状态码是否 499、502、504,以及 request_time 与 upstream_response_time 的差值。499 通常是客户端先断开,504 通常是上游超时。
3. 应用服务日志与线程/连接池状态
在应用日志里按 trace id 或请求路径搜索,确认请求进入时间、下游调用时间、结束时间。若使用 JVM,可在服务实例上执行 jstack <pid> > /tmp/jstack-$(date +%s).txt,检查是否有大量线程阻塞在数据库连接、HTTP 客户端或锁等待上。命令里的 pid 用 jps -l 或进程管理工具确认。
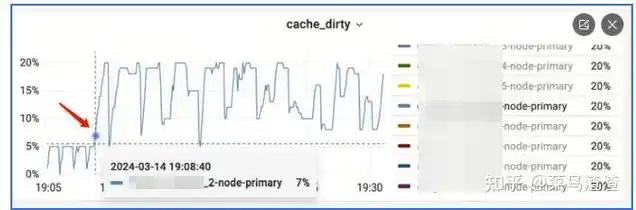
4. 依赖服务的面板字段
数据库看慢查询日志和当前连接数,缓存看命中率与连接数,第三方接口看其响应时间。面板字段要以实际部署的监控系统为准,建议先确认“响应时间”统计的是服务端耗时还是包含排队的端到端耗时,两者含义不同。
接口超时:按可能性从高到低排除
下面按常见程度排列,每一条都配一个能确认或排除它的动作。顺序不是绝对,需要结合环境确认。
- 下游依赖变慢或不可达。确认动作:在应用实例上直接对下游地址执行 curl 或 telnet 端口,比较耗时;对照应用日志里的下游调用耗时。处理:先确认下游是否发布、扩容或限流,再决定是否临时降级。
- 连接池或线程池耗尽。确认动作:看应用指标里的活跃连接数、等待队列长度,配合 jstack 看线程是否卡在获取连接。处理:核对连接池上限与数据库/下游的连接上限是否匹配,不要只调大应用侧。
- 慢 SQL 或缺少索引。确认动作:打开数据库慢查询日志,按接口时间点比对;对可疑 SQL 执行 EXPLAIN。处理:补索引或改查询,改前先在非生产环境验证执行计划。
- 超时阈值设置不合理。确认动作:对比客户端、网关、应用、下游四处的超时配置,确认是否逐层递减。常见问题是下游超时大于上游超时,导致上游先断、下游还在跑。处理:让超时从外到内依次收紧,并给重试留出预算。
- 流量突增或单实例异常。确认动作:对比各实例的请求量和响应时间,看是否集中在某一台。处理:摘除异常实例,再查该实例的 CPU、内存、GC 和网络。
- 网络链路问题。确认动作:从客户端和从网关分别对目标做分段 curl 或抓包,比较差异。处理:交由网络侧确认,不在应用层硬改。
容易踩的坑:看到超时就直接把超时时间调大。调大只会让请求等更久,若下游已经变慢,会进一步占用线程和连接,可能把局部问题放大。调大超时只能作为临时止血,并且要同时设置好上限和回滚。
接口超时:改完怎么确认真的解决了
改完配置或代码后,先用与故障时相同的路径复测:
for i in $(seq 1 20); do
  curl -o /dev/null -s -w '%{http_code} total:%{time_total}\n' https://你的接口地址
done
看返回码是否稳定、total 是否在阈值内、波动是否可接受。然后到网关日志确认不再出现 499/504,到应用日志确认下游调用耗时回落,到依赖面板确认连接数和慢查询恢复。
观察多久算稳定:建议至少覆盖一个业务高峰周期,具体时长按你们接口的调用规律确定,不要只看了几分钟没报错就结束。观察期内保留原配置和变更记录。
回滚办法不能缺:改配置前先备份原文件,例如 cp /etc/nginx/nginx.conf /etc/nginx/nginx.conf.bak.$(date +%Y%m%d%H%M);改完执行 nginx -t 校验,再 reload。若指标没有改善或出现新错误,执行 cp /etc/nginx/nginx.conf.bak.你的时间戳 /etc/nginx/nginx.conf && nginx -t && nginx -s reload。如果是应用侧连接池或超时参数,回滚到上一版配置并重启对应实例;如果发过代码版本,回退到上一发布版本。回滚后再用同一组 curl 命令确认返回码和耗时回到变更前水平。