AI 模型 API 的请求超时,通常不能靠一个数字解决。一次调用至少要区分三段:建连超时、等待首包或首个 token 的超时、整次调用的总时长上限。先判断自己是流式还是非流式、是用户在前台等待还是后台批处理,再决定每段时间设多长;否则只改一个全局 timeout,要么用户等太久,要么批量任务被误杀。
设置 AI 模型 API 超时的可行路径是:先分清非流式请求与流式请求,再分层设置建连、首包和总时长三个上限,并保证每一层都比调用链上层更短。流式请求重点看首 token 和空闲间隔,非流式请求看整体时长。改完后用可控制的慢响应或 mock 服务验证客户端是否按预期中断、连接是否释放。超时值需结合模型输出长度、上游稳定性和业务可接受等待时间确认,不能照抄他人配置。
先确认当前场景和目标
动手改配置前,先把下面几件事确认清楚,它们直接决定超时怎么切分:
- 调用方式是流式还是非流式。流式请求在持续有数据返回时,读超时通常不会触发,需要额外设置首 token 超时和相邻数据块之间的空闲超时;非流式请求只有一个整体等待时间。
- 谁在等这个结果。用户在前台同步等待,超时就要短,超时后要有降级或提示;后台批处理任务可以为单次调用留更长的整体时长。
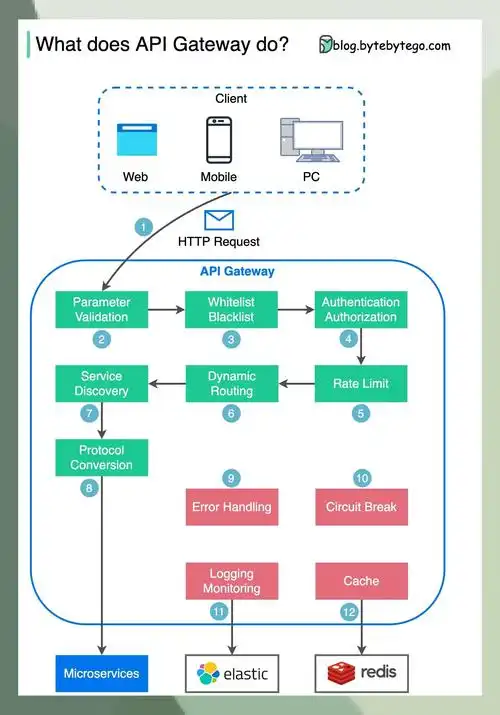
- 调用链上有几层超时。常见的有反向代理或网关、业务框架、HTTP 客户端或 SDK、以及更上层的页面或队列等待。任意一层比下面一层短,实际生效的就是最短的那层。
- 失败后能否重试。分类、摘要这类短输出且请求幂等的场景可以重试;长文本生成重试成本高,且可能产生重复计费,需要单独判断。
如果这几项还说不清,建议先只做一件事:在调用入口记录每次请求的建连耗时、首包耗时和总耗时,用一段时间的日志观察分布,再定值。凭感觉先写一个很大的超时,往往等于没有超时。
按这个顺序处理
第一步,把超时拆成字段,而不是一个总开关。多数 HTTP 客户端或 SDK 支持分别配置连接和读取,参数名各异,按你实际使用的库替换:
# 通用接入骨架,参数名按所用 SDK 或 HTTP 客户端替换
request_timeout = {
    "connect": 3,    # 建连阶段,通常可以设得比较短
    "read": 30,      # 非流式:等完整响应;流式:等首个 token
    "total": 90,     # 单次调用整体上限,覆盖所有阶段
}
第二步,按场景分配。非流式调用主要看 read 和 total,read 可以接近 total;流式调用要把 read 理解为首 token 等待,再单独加一个数据块之间的空闲上限,避免上游卡住不回数据时客户端一直挂着。
第三步,由内向外对齐。先确定前端或网关能容忍的最长等待,再让业务层超时略小于它,SDK 或 HTTP 客户端再略小于业务层。这样超时会在离调用最近的地方先触发,你能拿到明确的错误类型。
第四步,处理重试与超时的关系。如果要重试,需要满足:单次超时 × 最大尝试次数 + 退避间隔 ≤ 上层超时。否则外层先断,内层重试白做。建议只对建连失败、连接被重置、明确的 5xx 这类可安全重试的错误重试,对读超时谨慎重试,因为上游可能已经开始生成。
第五步,超时后要主动取消。捕获超时异常时显式关闭连接或取消请求,不要只依赖对象回收,否则连接池和并发槽位会被长时间占用。
改完后怎么验证
不要直接拿真实模型接口试,容易把慢响应当成网络问题。可以先用一个可控的 mock 服务,让它按设定延迟返回或不返回:
- 验证建连超时:把 mock 指向一个不会完成握手的地址,观察客户端是否在 connect 设定的时间附近抛出超时,而不是长时间无响应。
- 验证读超时:让 mock 接受连接后保持沉默,确认非流式请求在读超时到期时报错;流式请求则确认首 token 超时被触发。
- 验证总时长上限:让 mock 分多次缓慢返回数据,确认即使每段间隔都在空闲阈值内,整体到达 total 时仍会被终止。
- 验证取消与释放:超时后查看连接池活跃数是否回落,服务端是否收到断开,确认没有残留连接。
预期信号是:日志里能区分出超时发生在哪个阶段,错误类型稳定,同一个请求不会被重复处理两次。如果超时都报成同一种笼统错误,说明超时配置没有真正分层,需要回去补。
容易忽略的边界
几个常见坑:SDK 内部可能自带默认超时,会覆盖你传入的值,需要显式声明;不同库的超时单位是秒还是毫秒不一致,改配置时容易差一千倍;反向代理、负载均衡和容器平台常常有自己的空闲或请求超时,可能比你的业务超时短;流式场景下只要数据持续小流量到达,读超时就永远不会触发,必须有整体上限兜底。
不适用的情形也要说清:如果业务本身需要很长的生成结果,正确做法通常是改成异步任务加轮询或回调,而不是把同步超时拉到几分钟;如果上游模型服务经常在首 token 阶段抖动,单纯调大超时只会让失败更慢被发现,应先看上游的错误率和响应分布。回退建议是新值先在灰度流量或测试环境生效,保留旧配置一段时间,出现超时错误率异常时能快速切回,而不是一次性全量替换。