Function Calling 的配置工作可以拆成三件事:把函数写成模型能读懂的 JSON Schema,把 Schema 放进请求,把模型返回的调用参数在本地校验后才真正执行。判断配置是否成立,不看模型“愿不愿意调”,而看它在明确意图下能否稳定产出符合 Schema 的参数,以及你的代码在参数不合法、模型选错函数、模型干脆不调用这三种情况下是否有兜底。下面按定义、接线、验证、边界的顺序给出可替换片段,不绑定具体 SDK 写法。
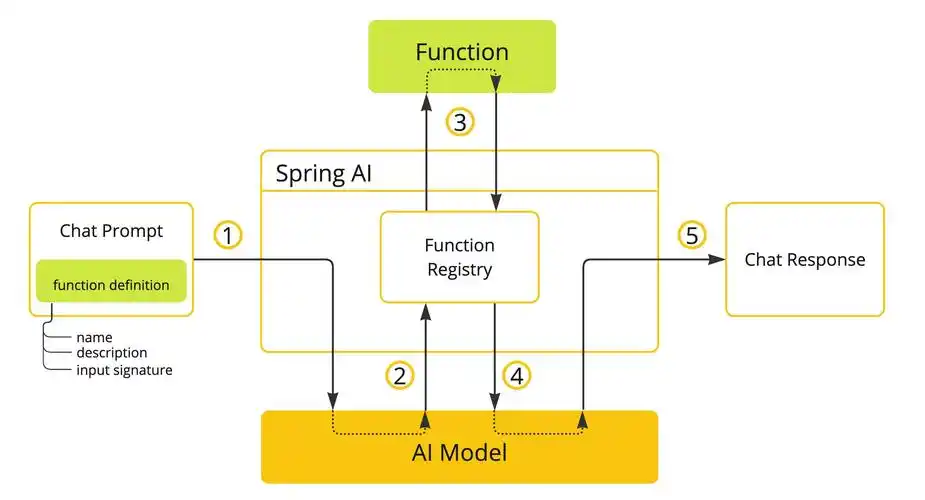
把 Function Calling 接进自己环境,先确认三件事:函数边界是否单一、Schema 是否把必填项和枚举写死、执行层是否有参数校验和次数上限。做法是先用 tools 数组注册函数并用 description 说明“何时用、何时不用”,模型返回 tool_calls 后在本地校验再执行,结果以 tool 消息回传。验证看四点:意图命中、缺参拒绝、无匹配不硬调、回传后模型不再重复调用。字段命名、strict 模式支持和写操作权限需要结合所用接口版本与业务账号确认,不满足时回退到提示词解析。
先确认当前场景和目标
不是所有任务都值得上 Function Calling。判断条件是:这个函数需要模型从自然语言里抽取参数,且参数直接影响结果。如果参数是固定模板或由前端表单传入,直接用普通接口拼装更省事;如果只是让模型输出一段文本再由你正则取字段,先用提示词约束往往更轻。
落手前需要确认的几项信息:
- 函数边界:一个函数只做一件事。把“查询订单”“取消订单”“退款”拆成三个函数,而不是一个
order_action加自由文本参数,否则模型容易在参数里塞自然语言。 - 调用方式:是否只读。查询类函数可以放开自动执行;涉及写入、扣款、发消息的函数,建议在执行前增加一次人工确认或二次校验。
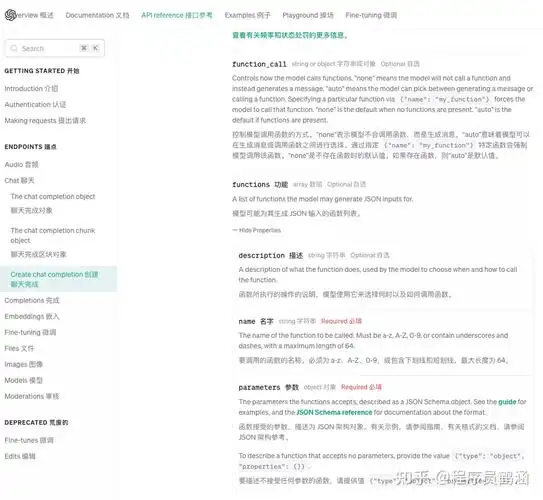
- 接口字段:不同接口版本对函数注册字段的命名有差异(
tools与早期functions并存的情况常见),需要以当前 SDK 或请求文档为准,不要照抄旧示例。 - 函数数量:同一请求里注册的函数越多,描述之间的区分度越难保证。通常先把高频的 3 到 5 个做完,再逐步加。
按这个顺序处理
第一步写函数清单,第二步写 Schema,第三步写描述,第四步组装请求,第五步做本地校验,第六步回传结果并限制循环次数。顺序不要颠倒,描述写不好时先改清单,而不是在参数里加注释。
1. 函数定义片段(可替换)
下面是一个通用的函数定义结构,字段名按你所用接口版本核对后套用。重点在 required、enum 和参数说明,这三处决定了模型能不能给出可执行的值。
{
  "name": "query_order_status",
  "description": "按订单号查询订单当前状态。仅用于查询,不修改任何数据。当用户未提供订单号时不要调用此函数,应先向用户询问。",
  "parameters": {
    "type": "object",
    "properties": {
      "order_id": {
        "type": "string",
        "description": "订单号,纯数字或字母组合,不含空格和中文"
      },
      "channel": {
        "type": "string",
        "enum": ["web", "app", "offline"],
        "description": "订单来源渠道,不确定时传 web"
      }
    },
    "required": ["order_id"]
  }
}替换项:name 用动词加名词的小写下划线格式;description 里显式写出“不适用条件”,例如“用户未提供订单号时不要调用”;枚举值只放真实存在的取值,不要留“其他”这种兜底项,否则模型会把无法识别的输入塞进去。
2. 请求组装骨架
# 通用骨架,字段名以当前接口为准
payload = {
    "model": MODEL_NAME,
    "messages": messages,          # 含 system 与用户消息
    "tools": [tool_def_1, tool_def_2],
    "tool_choice": "auto"          # 或指定单个函数名强制调用
}
resp = call_model(payload)
for call in resp.tool_calls:
    args = json.loads(call.arguments)   # 解析失败要捕获
    validate(call.name, args)           # 校验通过才执行
    result = dispatch(call.name, args)
    messages.append(tool_message(call.id, result))
# 二次请求让模型基于结果作答
tool_choice 在调试阶段可以先固定成某个函数名,确认参数抽取没问题后再切回自动选择;如果接口版本不支持该字段,忽略这一项,改用描述里的强约束。
3. 本地校验片段
ALLOWED = {"query_order_status": ["order_id", "channel"]}

def validate(name, args):
    if name not in ALLOWED:
        raise ValueError("unregistered function")
    unknown = set(args) - set(ALLOWED[name])
    if unknown:
        raise ValueError("unexpected args: %s" % unknown)
    if name == "query_order_status" and not args.get("order_id"):
        raise ValueError("missing order_id")
    return True
这一段是整条链路里最容易被跳过、也最该保留的部分。模型给出的参数本质上属于外部输入,需要按外部输入对待:类型、枚举、长度、是否越权都要在这里挡掉,执行函数本身不要再做隐式兜底。
改完后怎么验证
验证不靠“聊几句感觉对”,而是按意图和参数分别构造输入,观察 tool_calls 里的 name 和 arguments 是否符合预期。建议在日志里同时打印原始返回和校验结果,方便定位是模型选错函数还是参数抽取出错。
- 单一意图:输入“帮我查一下订单 12345 的状态”,预期命中
query_order_status,且order_id为12345,不带多余字段。 - 缺必填:输入“查一下我的订单”,预期不调用函数,而是反问订单号;如果直接调用并传空值,说明描述的“不适用条件”没写清。
- 枚举校验:输入里明确提到渠道时,观察
channel是否落在枚举内;落到枚举外说明校验层需要拦截。 - 无匹配函数:问一个函数集合覆盖不到的问题,预期不调用或调用后被你的白名单拒绝,而不是硬套一个相近函数。
- 回传后行为:把执行结果作为 tool 消息回传后,预期模型基于结果组织回答并停止继续调用;如果反复调用同一函数,需要检查结果是否为空或格式不可读,并加上循环上限。
预期信号是:正常意图下函数命中和参数都稳定,异常意图下你的校验层抛出可读错误而不是执行副作用操作。达不到这两点,先改描述和 Schema,不要急着换模型。
容易忽略的边界
字段与版本差异:函数注册的字段名、是否支持强制指定函数、是否支持严格结构化输出,在不同接口版本和模型上并不一致,需要结合你实际接入的 SDK 与模型能力确认,不能拿一份示例全量套用。不支持时回退到提示词约束加本地解析,功能可用但稳定性要靠校验层兜。
模型不保证一定调用:即使描述写得很清楚,也可能出现该调不调、不该调却调的情况。业务侧需要有非函数分支的处理逻辑,例如直接提示用户补充信息,而不是让流程卡住。
写操作权限:函数背后的数据库账号或服务凭证建议按最小权限配置,只读函数和写函数使用不同凭证。删除、退款、发通知这类动作,建议在执行前增加确认环节,避免模型误判参数直接落库。
超时与重试:函数执行超时后不要静默返回空字符串,模型会把空结果当作事实继续推理。回传错误信息时给出简短、结构化的原因,并设置单次会话的调用次数上限,防止循环。
不适用的情况:参数高度自由(长文本、代码、复杂嵌套结构)、或函数副作用不可撤销时,不适合直接交给自动调用,可以先做意图分类,再由固定流程收集参数,Function Calling 只承担分类这一步。