配置 Sentinel 熔断降级规则,关键不在于记住几个参数字段,而在于先判断“这条资源最容易怎么坏”——是下游变慢、错误率抬升,还是低流量下出几条异常就该停。判断清楚了,再选 grade、定阈值、决定用代码加载还是配置中心推送,最后用可控的失败流量确认 blockHandler 真的被命中、窗口结束后能回到半开状态。跳过前三步直接抄一段规则,往往表现为“规则生效了但没拦住”,或者“拦得太频繁导致正常请求被误伤”。
熔断规则通常按资源维度配置:慢调用比例适合下游延时上升但成功率仍正常的场景,异常比例适合流量较稳定、错误率有意义的接口,异常数适合调用量小、几条失败就值得阻断的链路。先用代码 loadRules 或配置中心推送把规则跑通,再用人工构造的慢调用与异常确认熔断被触发、fallback 返回预期结果、timeWindow 结束后有请求被放行。若异常在业务层被 try-catch 吞掉,或规则未持久化到配置中心,配置会表现为“写了但不生效”。
先确认当前场景和目标
动手写规则前,先把下面几件事确认清楚,否则阈值只能凭感觉填。
- 资源粒度:资源名建议落在“一个下游依赖”或“一个对外接口”这一层,不要细到每个内部方法都配一条,规则一多就没人维护了。
- 失败形态:下游变慢但结果正确,走慢调用比例;错误率随流量上升明显,走异常比例;调用量本身不大,几次失败就足以拖垮上游线程池,走异常数。这个对应关系决定了 grade 取值。
- 异常能否被统计到:如果业务代码里把下游异常 catch 住后转成正常返回,Sentinel 统计不到异常,异常比例和异常数都不会触发。
- 是否有兜底:熔断后请求会抛 BlockException,没有 blockHandler 或 fallback 的接口会直接把异常抛给调用方,这属于改变了对外行为,需要先确认调用方能否接受。
- 版本差异:Sentinel 1.8 前后熔断相关的 API 与字段不一致,先确认项目里实际引入的版本,再决定示例中的写法是否需要替换成对应的常量。
一个简单的判断表(grade 数值以实际依赖版本的枚举为准,不要硬编码数字):
| 场景特征 | 规则类型 | count 的含义 |
|---|---|---|
| 响应时间明显拉长,成功率正常 | 慢调用比例 | 慢调用判定阈值,单位毫秒 |
| 流量稳定,错误率可统计 | 异常比例 | 0 到 1 之间的比例 |
| 调用量小,少量异常即需阻断 | 异常数 | 统计窗口内的异常条数 |
按这个顺序处理
- 确认依赖版本与资源定义方式(注解或手动埋点),保证资源名在 Dashboard 的簇点链路里能看到。
- 按上面的判断表选 grade,先给一个偏宽松的阈值,例如慢调用阈值取当前观察到的响应时间上方一档,minRequestAmount 显式设置,避免样本太少时误判。
- 用代码加载规则验证行为,再迁移到配置中心持久化。
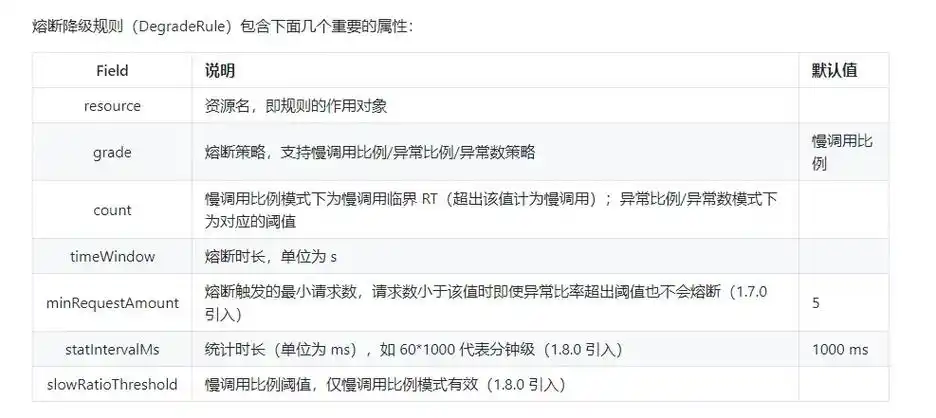
下面是一段可直接替换的加载片段,三个规则分别对应慢调用、异常比例、异常数,实际使用按需保留一种:
List<DegradeRule> rules = new ArrayList<>();

DegradeRule slow = new DegradeRule();
slow.setResource("queryOrder");
slow.setGrade(CircuitBreakerStrategy.SLOW_REQUEST_RATIO.getType());
slow.setCount(200);              // 慢调用 RT 阈值,毫秒
slow.setSlowRatioThreshold(0.5); // 慢调用比例阈值
slow.setMinRequestAmount(20);    // 窗口内最小请求数
slow.setStatIntervalMs(10000);   // 统计窗口
slow.setTimeWindow(15);          // 熔断时长,单位秒
rules.add(slow);

DegradeRule errRatio = new DegradeRule();
errRatio.setResource("queryOrder");
errRatio.setGrade(CircuitBreakerStrategy.ERROR_RATIO.getType());
errRatio.setCount(0.3);
errRatio.setMinRequestAmount(20);
errRatio.setStatIntervalMs(10000);
errRatio.setTimeWindow(10);
rules.add(errRatio);

DegradeRule errCount = new DegradeRule();
errCount.setResource("queryOrder");
errCount.setGrade(CircuitBreakerStrategy.ERROR_COUNT.getType());
errCount.setCount(10);
errCount.setStatIntervalMs(10000);
errCount.setTimeWindow(10);
rules.add(errCount);

DegradeRuleManager.loadRules(rules);
如果走 Spring Cloud Alibaba 的配置中心下发,改为 datasource 方式,把规则 JSON 放在配置中心,rule-type 指定为 degrade,应用启动时自动拉取,修改后推送到各实例。规则 JSON 的字段与上面代码里的字段一一对应,资源名、阈值、窗口都按实际环境替换。
资源侧需要一个兜底方法,签名要匹配:blockHandler 收到的是 BlockException,fallback 收到的是 Throwable,两者都不要在内部再调用同一个资源,否则会形成回环。
改完后怎么验证
验证不要依赖线上真实流量,用可控手段制造失败:
- 把下游响应人为拉长,或让被保护方法按条件抛异常,构造出熔断条件。
- 观察 blockHandler 是否被调用,日志里出现降级返回,说明熔断已经打开。
- 在熔断窗口内继续发起请求,预期是快速失败、耗时明显低于上游超时时间,而不是继续等待。
- 等待 timeWindow 结束后再发少量请求,预期有请求被放行进入半开探测;如果继续全部被拒,先查 timeWindow 是否设得过长,再查请求是否走了另一条资源名。
- 在 Dashboard 的熔断规则与簇点链路页面确认规则已下发到该实例,避免出现“配置中心有、实例没拉到”的情况。
预期信号是三条:熔断期间失败快速返回且走兜底逻辑;窗口结束后能恢复到正常放行;恢复正常后规则不会立刻再次误触发。任何一条不满足,回到统计窗口和 minRequestAmount 上找原因。
容易忽略的边界
- timeWindow 单位是秒,慢调用 count 单位是毫秒,两者混淆是最常见的配置错误。
- 统计窗口过短会让样本量不足,慢调用比例在低流量下几乎不可能触发;建议显式设置 statIntervalMs,而不是依赖默认值。
- 熔断状态默认是单实例本地内存,多实例部署时各实例独立统计,一个实例打开熔断不代表其他实例也打开;规则通过配置中心下发能保证阈值一致,但状态不共享。
- 规则不持久化时,重启即丢失,Dashboard 上改的规则只在当前实例内存里生效。
- 异常被内部捕获后不再计入统计,熔断不会触发,需要把失败信息以异常形式抛出,或在埋点层显式记录。
- 不适用条件:链路本身没有兜底返回、调用方无法处理快速失败时,不建议直接上熔断,可以先做限流或超时控制;如果只是临时止血,熔断不能当成性能优化手段。
- 回退建议:阈值不确定时,先把 minRequestAmount 和统计窗口调大、把比例阈值调宽,观察一段时间再收紧;出现误伤时优先回退规则而非直接调大 timeWindow,避免熔断窗口过长导致恢复变慢。