API 中转站做多后端负载均衡,需要先决定三件事:上游怎么分组、请求按什么规则分发、某个后端失败时请求怎么转移。只把 nginx 的 upstream 配置写进去,通常只覆盖了分发这一步,配额、会话粘性和流式输出这几项后续容易出现问题。下面的做法以“多个同类上游可以互换”为前提,如果上游之间返回结构差异较大,需要先在网关层做字段归一化。
API 中转站的多后端负载均衡,关键是先把上游按可互换性分组,再确定分发策略和失败转移规则;单纯轮询只解决分发,不解决配额、会话和流式输出。建议先用加权分发加被动健康检查跑通,用响应头标记和访问日志确认请求确实落在不同后端、摘掉一台后客户端无感,再考虑主动探测或自研调度。上游只有两三个时,简单策略往往比复杂调度更好维护。
先确认当前场景和目标
动手前先确认四件事,任何一条不成立,后面的配置思路就要换。
- 可互换性:几个上游是否提供同一模型或同一能力的等价接口,返回字段、错误码含义是否一致。不一致就先做映射层,否则负载均衡会把不同格式的响应混着返回给客户端。
- 是否有状态:多轮对话、带上下文缓存或按 key 计费的场景,纯轮询会打断会话连续性,需要按 session 或按 API key 做哈希粘性。
- 配额分布:各上游的额度、并发上限不一样时,分摊比例就不能平均,权重要能反映实际容量。
- 是否流式:客户端走 SSE 流式返回时,缓冲、重试、超时三处都要单独处理,不能沿用普通 JSON 请求的配置。
如果这几项还不清楚,先只接一个后端跑通链路,再逐个加,比一次性配齐多个后端更容易定位问题。
按这个顺序处理
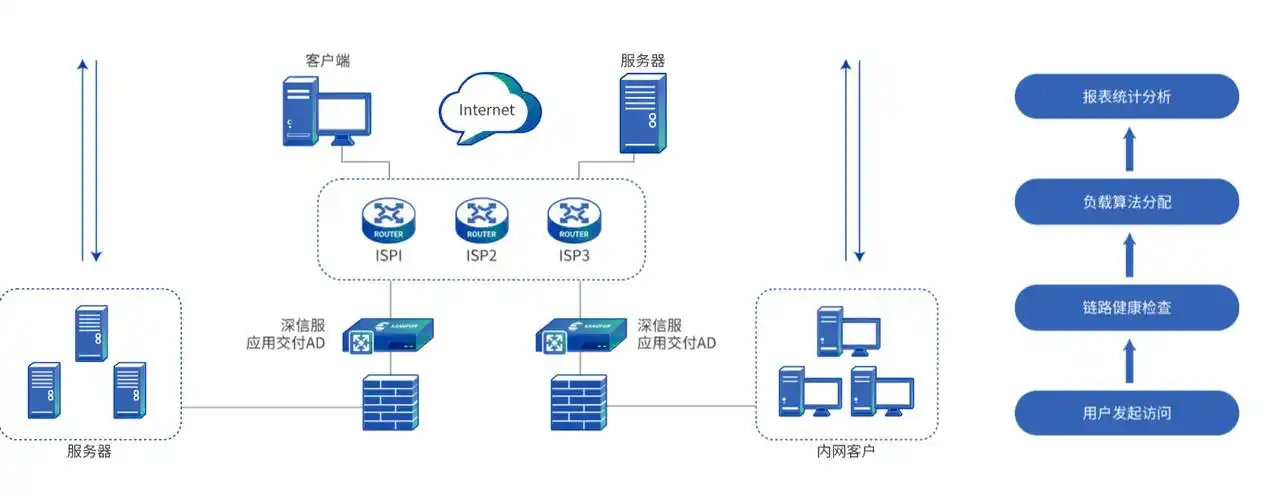
建议按“分组 → 分发 → 失败转移 → 超时与流式 → 鉴权替换”的顺序配置,每一步都可以单独验证。
- 分组:按供应商或按能力建多个上游池,不要把不同上游的 key 混进同一个池,否则出问题时无法按组摘除。
- 分发策略:上游并发能力接近时用轮询,差异明显时用加权,长连接较多时用最少连接。
- 失败转移:只对连接失败、超时和 5xx 做换后端的重试;401、429 通常代表配额或凭据问题,换后端也可能落在同样受限的池子里,更适合先做冷却不重试。
- 超时与流式:读超时按上游实际响应时间设置,流式接口关闭响应缓冲。
- 鉴权替换:客户端只认中转站自己的 key,上游 key 在网关侧替换,避免把上游凭据暴露到客户端。
下面是一个可替换的 nginx 片段,放在 http 块内的 server 外面定义上游,location 里做转发。地址、权重、超时都要按你的实际上游改;proxy_set_header X-Upstream $upstream_addr 是给自己排查用的,上线后可以保留在日志里。
upstream api_pool {
    least_conn;
    server 10.0.0.11:8080 weight=3 max_fails=2 fail_timeout=15s;
    server 10.0.0.12:8080 weight=1 max_fails=2 fail_timeout=15s;
    keepalive 32;
}

location /v1/ {
    proxy_pass http://api_pool;
    proxy_http_version 1.1;
    proxy_set_header Connection "";
    proxy_set_header Host $host;
    proxy_set_header X-Upstream $upstream_addr;
    proxy_next_upstream error timeout http_502 http_503 http_504;
    proxy_next_upstream_tries 2;
    proxy_connect_timeout 5s;
    proxy_read_timeout 120s;
    proxy_buffering off;
}
如果中转站是自研服务而不是反向代理,同样可以用一张路由表来表达上面几个判断。下面只是骨架,字段名按你现有配置结构替换,用途是让权重、重试和冷却三件事集中在一处,便于按上游单独调整。
{
  "upstreams": [
    {"name": "vendor-a", "base_url": "https://a.example.com", "weight": 3, "max_concurrency": 32},
    {"name": "vendor-b", "base_url": "https://b.example.com", "weight": 1, "max_concurrency": 16}
  ],
  "routing": {"strategy": "weighted_least_pending", "sticky_by": "session_id"},
  "retry": {"on": ["connect_error", "timeout", "http_5xx"], "max_attempts": 2},
  "cooldown": {"on": ["http_401", "http_429"], "duration_ms": 60000},
  "stream": {"buffer": false, "retry_after_first_byte": false}
}
其中 sticky_by 决定会话粘性键,retry_after_first_byte 控制流式响应已经开始输出后是否还允许重试,这两项最容易漏配。
改完后怎么验证
验证要能看到“请求落在哪台后端”,否则只能看到客户端成功或失败。先确保响应头或访问日志里有 X-Upstream、upstream_addr、upstream_status 这几项记录。
- 分发是否生效:连续发若干次同一个请求,把返回里的上游标记收集起来,看是否覆盖到池内各后端,而不是全部落在一台上。
- 摘除是否无感:把其中一台的 weight 改成 0 或直接停掉服务,再发同样的请求,客户端应仍能拿到正常响应,日志里不再出现该地址。
- 失败转移是否按预期触发:让某台后端返回 503(可临时改配置模拟),观察是否换到另一台;再让它返回 401 或 429,确认请求进入冷却而没有被反复重试。
- 流式是否被缓冲:发一个带流式参数的请求,观察首段内容是否及时返回、有没有被攒到一起再吐出。如果首字节延迟明显变大,多半是缓冲没关或前置层在缓冲。
- 会话粘性是否成立:对同一 session 连发多次,看是否稳定命中同一后端;切换 session 后是否换到其它后端。
预期信号是:同一客户端的请求能分布到不同后端,摘除一台后客户端侧不出现新的报错,日志里能看到每次请求的上游地址与上游状态码。如果摘除后报错明显变多,先回去检查重试条件是否把不该重试的状态码也算进去了。
容易忽略的边界
- 流式被缓冲:nginx 默认开启响应缓冲,还会和 gzip、前置 CDN 一起叠加以致流式失效,流式路径需要单独关闭缓冲。
- 重试的幂等性:创建任务、计费类请求重试可能产生重复记录;流式请求一旦已经向客户端输出内容,就不能再换后端重来。
- 429 与配额:上游限流时切到另一家,可能只是把超限压力转移过去,需要网关侧有全局配额视图,否则多个池会同时被打满。
- 健康检查过于激进:被动失败计数和主动探测同时配得很紧时,一次网络抖动就可能把可用后端摘掉,导致其余后端承担全部流量。
- 版本与字段差异:不同上游的 API 版本、错误码含义、usage 字段结构可能不同,需要在网关层做归一化,否则客户端会间歇性解析失败。
- 回退建议:如果只是两三个上游且协议一致,先只用加权轮询加被动健康检查,把日志和上游标记补齐;确认分发和摘除行为符合预期后,再考虑主动探测、最少连接或自研调度。改动期间保留一份最小可用配置,出现异常时能快速回退到单后端直连。