把 Redis 持久化关掉之后,数据会不会丢,取决于你怎么定义“丢”。只要 Redis 进程还在运行、内存没有被回收,数据就仍然能读能写;但进程重启、机器宕机、容器被重建、OOM 被杀或运维手动重启,内存里的数据就没了。判断的关键在于这份 Redis 里存的是可以回源重建的缓存,还是唯一一份数据。如果是前者,关闭持久化通常可以接受;如果是后者,或者回源会给数据库带来不可控的压力,就不应该全部关闭。
关闭持久化(save ""配appendonly no)后,数据只存在于内存,任何导致进程退出的情况都会丢数据,重启后是一个空实例。适合:数据能从上游重建、有副本或定期备份、能接受冷启动回源。不适合:会话、队列、计数器、锁等无法重建的数据。建议先在测试实例上确认配置已生效,再做一次重启演练,观察DBSIZE变化,并保留一份独立的备份或从库作为回退。
先确认当前场景和目标
动手前先把下面几件事确认清楚,否则很容易改成“以为关了持久化,实际旧快照还在被加载”,或者“关了之后才发现回源扛不住”。
- 数据性质:Redis 里存的是缓存副本,还是唯一数据源。缓存副本通常可以关;业务状态、队列、分布式锁这类数据关闭持久化等于放弃可靠性。
- 上游能否重建:数据库能否在缓存击穿时扛住回源流量,是否有互斥重建、限流或预热机制。没有的话,宁可降低快照频率,也不要直接关闭持久化。
- 是否有其他副本:是否存在从库、跨机房副本或定时备份任务。注意主从复制本身也会产生 RDB(全量同步),不能当成关闭了持久化。
- 运行形态:是自建还是托管实例。托管 Redis 通常有平台侧备份,能否关闭持久化需要看控制台是否开放该参数。
- 可接受的恢复状态:重启后允许是空实例,还是至少要保留最后一小时的数据。这决定了是全部关闭,还是只降频
save。
按这个顺序处理
第一步,先确认当前真实配置,不要只看配置文件,因为运行中的值可能被 CONFIG SET 覆盖过:
redis-cli CONFIG GET save
redis-cli CONFIG GET appendonly
redis-cli CONFIG GET dir
redis-cli CONFIG GET dbfilename
redis-cli INFO persistence
看 save 是否为空串、appendonly 是否为 no,以及 dir 目录下是否还留着旧的 dump.rdb 或 appendonly 文件。旧文件不会因为你关闭持久化就消失,它会成为后面误判的来源。
第二步,在配置文件里改,而不是只用 CONFIG SET。 运行时改的值重启后会回到配置文件的内容,容易变成“改完有效、重启后又开始落盘”或反过来。示例片段如下,替换成你自己的配置文件路径和目录:
# redis.conf 片段
save ""
appendonly no

dir /var/lib/redis
dbfilename dump.rdb
改完如果实例支持 CONFIG REWRITE,可以确认写回结果;不支持或配置文件受管控时,以配置文件为准重启一次。较新版本支持动态关闭自动快照,但要结合版本和 CONFIG REWRITE 是否可用确认,不要默认所有版本行为一致。
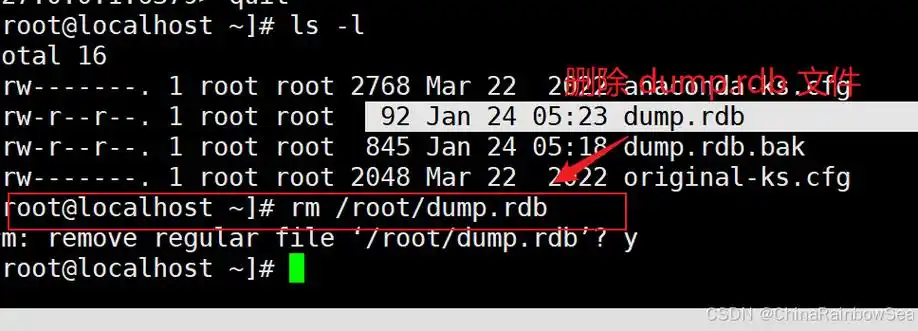
第三步,处理残留文件和退出路径。 关闭持久化后,正常停止建议用 redis-cli SHUTDOWN NOSAVE,避免退出流程再触发一次保存;同时确认目录里旧的 RDB 文件是否需要清理或归档。这里的分寸是:清理前先确认没有其他实例指向同一 dir,否则容易误删别人的快照。
第四步,留好回退路线。 关闭持久化不等于放弃备份。可以让从库保留快照,或用独立任务定期执行 BGSAVE 后拷走文件。这样一旦发现回源压力过大,还能把 save 加回来或从备份恢复,而不必从零开始。
改完后怎么验证
验证分两层:配置是否真的生效,以及重启后行为是否符合预期。
- 配置层:再次执行
CONFIG GET save和CONFIG GET appendonly,预期分别返回空串和no;INFO persistence里aof_enabled为 0。 - 文件层:观察
dir目录,在持续写入一段时间后不应再出现新的dump.rdb或 AOF 增长。已有旧文件的时间戳应保持不变。 - 重启层:在隔离的测试实例上写入若干 key,记录
DBSIZE,然后重启进程,重启后DBSIZE预期归零。这就是关闭持久化后的真实行为,提前看到比线上遇到好。如果实例开启了 debug 命令,DEBUG RELOAD也能模拟加载,但该命令在多数环境下默认禁用,不要为此放开权限。 - 回源层:重启后观察上游数据库的负载和缓存重建速度,确认业务能接受冷启动。这一步只能在自己的环境里看,没有通用数值。
如果重启后 DBSIZE 不为零,说明还有别的加载路径在起作用,优先检查旧 RDB 文件、从库全量同步和平台侧备份恢复策略。
容易忽略的边界
- 主从与集群:从库在全量同步时通常会落盘生成 RDB(部分版本可用无盘复制规避),因此主库关闭持久化不代表整个集群没有落盘。集群模式下节点重启同样会丢数据。
- 停止方式:不同版本在停止时是否触发保存、是否受
save配置影响,行为不完全一致,建议显式使用SHUTDOWN NOSAVE,并在自己的版本上确认一次。 - 容器与编排:容器重建、滚动发布、节点驱逐都会导致进程退出,这类环境关闭持久化后丢失是常态,不是异常。
- 托管实例:平台可能强制开启备份或不允许关闭持久化,控制台改不动时以平台能力为准,不要直接改底层配置文件。
- 不适用条件:数据可重建性不确定、回源没有保护、存在不可重放的写操作时,不适合关闭持久化。可以先把
save改成更稀疏的规则,或保留 AOF 的everysec,作为过渡。 - 回退建议:改回持久化时,先恢复
save或appendonly yes,再确认INFO persistence的加载状态,避免在旧文件缺失的情况下直接重启导致空库上线。