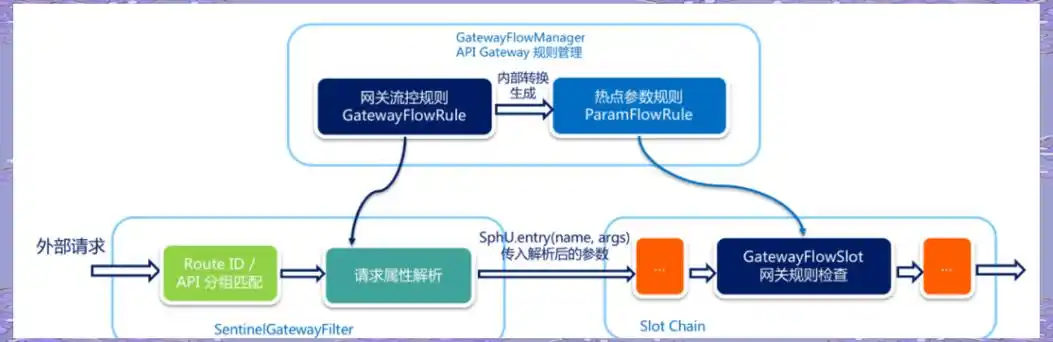
限流放网关还是放服务内,通常不是二选一,而是分层:入口层做粗粒度保护,服务内做与业务语义绑定的细粒度控制。先判断你要挡的是“整个入口被打穿”,还是“某个接口、某类用户或某个下游依赖被拖垮”。如果只做网关限流,服务被内部调用绕过时就没有保护;如果只做服务内限流,恶意流量仍会消耗连接、TLS 和转发资源。建议先用网关兜住总量,再对关键接口在服务内补一层。
判断方向:面向外部流量的总量保护优先放网关,按用户、租户、接口、下游依赖维度的限流放服务内。操作上先盘点入口与内部调用路径,确认限流键、阈值来源和超限响应,再决定分层。验证时看被限请求的分布、误伤比例和下游是否仍被打满。边界在于网关通常拿不到完整业务上下文,服务内限流则无法拦住进入集群前的流量,两者都不能替代容量评估和降级预案。
先确认当前场景和目标
在动手前,需要先把几个事实确认清楚,否则容易把限流做成“看起来有、实际拦不住”。
- 流量入口是否唯一。如果服务除了经过网关,还会被内部 RPC、消息消费、定时任务或运维脚本直接调用,网关限流就覆盖不到这些路径。
- 限流维度是什么。按 IP、按接口、按用户 ID、按租户、按下游依赖分别对应不同的实现位置。网关通常擅长 IP、路径、请求头维度;服务内更容易拿到用户身份、业务参数和调用链上下文。
- 超限后的期望行为。返回 429、排队、降级到缓存结果还是直接拒绝,这决定了限流器需要放在调用链的哪一段。
- 阈值从哪里来。是否有容量评估、压测结论或历史峰值作为依据,还是只能先设一个保守值再调整。
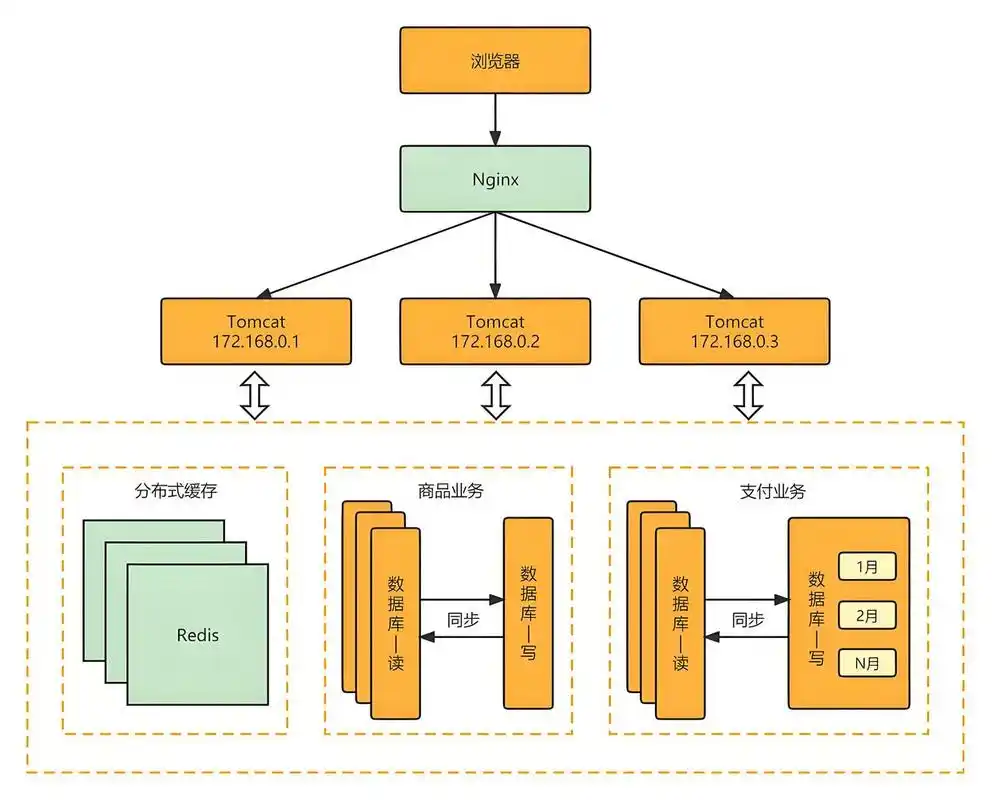
- 是否存在多副本。服务内限流在多个实例上是各自计数还是共享计数,需要结合具体实现确认,单机计数在扩容后会放大总放行量。
如果以上信息还不全,可以先按“网关做总量、服务内做关键接口”的默认策略起步,但要把阈值来源和调整方式记录下来,避免后续无人敢改。
按这个顺序处理
建议按下面顺序推进,每一步都能独立验证,不必一次做完。
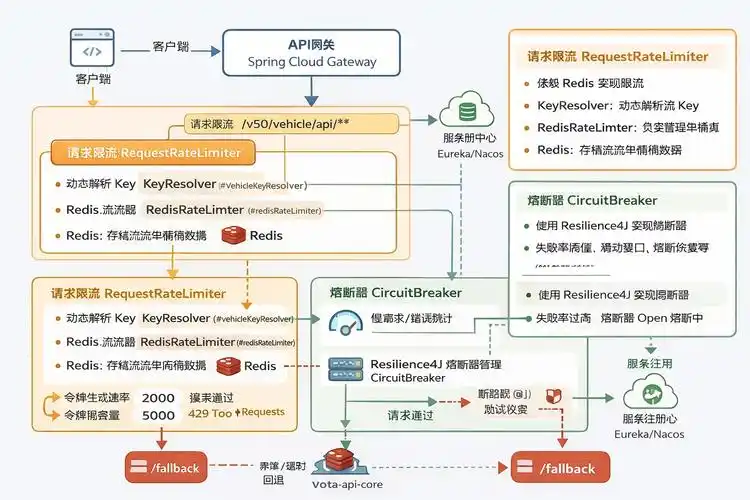
- 画清调用路径。列出所有能打到核心服务的入口,标注哪些经过网关、哪些是内部直连。只有经过网关的流量才归网关限流管。
- 在网关配置总量和路径级限流。以路径或路由为键,先设一个明显保守的阈值,确保异常流量不会直接压到后端。下面是通用配置骨架,具体字段需要按你使用的网关产品替换。
# 通用网关限流骨架,字段名按实际网关调整
route: /api/order/**
limit:
  key: client_ip        # 也可换成 header 中的租户标识
  rate: <保守阈值>       # 结合容量评估填写,不要照抄
  burst: <短时突发额度>
  action: reject
  response_code: 429
response_body: {"code":"RATE_LIMITED","retry_after":1}- 在服务内补业务维度限流。对下单、支付、登录、查询重接口等关键路径,用用户 ID 或租户 ID 作为限流键。下面的骨架只表达逻辑,具体 API 按你使用的限流库替换。
// 服务内限流判断骨架(伪代码,按实际限流库替换)
key = "order:create:" + userId
if (!limiter.tryAcquire(key)) {
    return response(429, "RATE_LIMITED");
}
// 通过后再执行业务逻辑- 确认多实例计数方式。如果服务是多副本部署,需要明确服务内限流是单机计数还是共享计数。单机计数实现简单,但总放行量随副本数增加;共享计数需要额外的存储或协调组件,要评估其可用性和延迟。
- 约定限流键的生成规则。同一类请求的键必须稳定,否则限流会失效。例如未登录用户按 IP 还是设备标识,代理场景下取哪个请求头,都要写清楚并在网关与服务内保持一致。
- 给限流留出可观测信息。至少记录被限的键、路径、时间和来源,便于后续判断阈值是否过低或过高。
改完后怎么验证
限流上线后,不要只看“有没有返回 429”,要确认拦截位置和影响范围符合预期。
- 验证网关是否生效。用受控的测试请求在单一路径上持续发送,观察是否在预期阈值附近开始返回 429,并确认后端服务收到的请求量同步下降。预期信号是:超限请求在网关侧被拦下,后端日志中不出现这批请求。
- 验证内部直连是否被覆盖。绕过网关直接调用服务,确认服务内限流是否按预期生效。预期信号是:直连路径同样受到业务维度限流约束,而不是完全放行。
- 观察误伤情况。对比被限请求的分布,确认没有把正常用户或关键业务路径大面积拦掉。如果某个租户或某类客户端集中被限,需要复核限流键是否选错。
- 确认下游压力。限流生效期间观察数据库、缓存和第三方接口的负载是否回落到可接受范围。限流没有缓解下游压力,通常说明拦截点放得太靠后。
- 验证超限响应。确认 429 响应包含可用的重试提示,客户端或调用方能据此退避,而不是立即重试形成二次冲击。
验证过程中如果发现阈值明显不合理,先调整配置再复测,不要用临时放宽的方式掩盖问题。
容易忽略的边界
- 网关看不到业务上下文。按用户或租户限流时,如果身份信息在网关层不可靠或缺失,网关限流只能退化为 IP 或路径维度,精度有限。这类需求应放到服务内。
- 服务内限流挡不住入口流量。连接数、TLS 握手、大包请求等消耗发生在到达服务之前,服务内限流无法缓解这类压力,仍需要入口层保护。
- 共享计数组件本身是依赖。使用集中式存储做全局限流时,该组件的不可用会直接影响请求放行。建议设定失败时的降级策略,例如放行并记录告警,或按本地计数兜底,具体取舍需要结合业务容忍度确认。
- 限流不能替代容量和降级。限流只是把超出部分挡住,不提升系统处理能力。核心链路仍需要有超时、熔断和降级预案。
- 多环境阈值不同。测试环境和生产环境的容量差异较大,阈值配置应分开管理,避免把测试值带到线上。
- 回退方式要提前想好。如果限流上线后出现明显误伤,需要能快速关闭或放宽某条规则。建议限流配置支持按路由或按开关独立调整,而不是只能整体回滚发布。
不适用的情况也要说清楚:如果系统流量规模很小、入口单一且没有明显突发,先做基础监控和容量记录即可,不必急着引入多层限流;如果业务对可用性要求极高且无法接受集中式计数组件故障,优先选择单机计数加保守阈值,并接受总量控制不精确的代价。