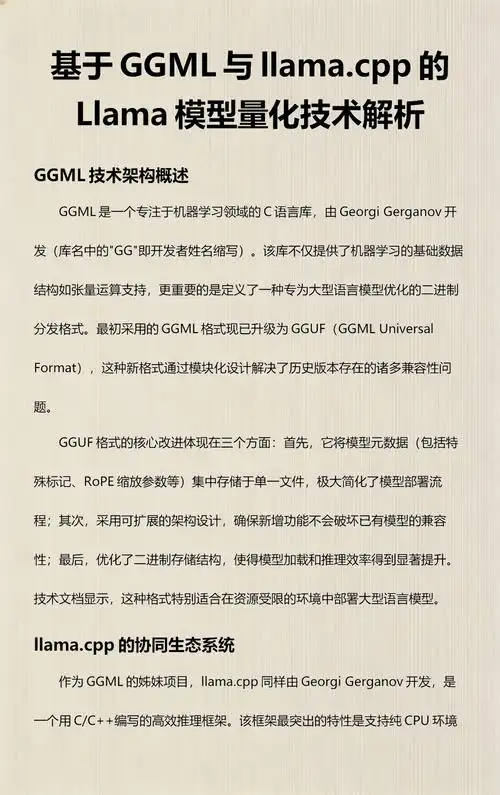
GGUF 是 llama.cpp 生态主推的模型文件容器格式,可以把它理解为“一个文件里同时装下张量权重、量化信息和元数据(架构、上下文长度、分词器、对话模板等)”。GGML 则有两层含义:一是早期 llama.cpp 使用的旧模型文件格式(常见的 .bin 文件),二是底层张量计算库的名字。所以两者不是并列的新旧产品,而是“同一个库的旧格式与新格式”。判断方法很简单:文件后缀是 .gguf,就按 GGUF 处理;遇到 .bin 且加载时报不了 GGUF 魔数,多半是旧 GGML 格式,不能靠改后缀解决。
适用场景:本地或边缘设备用 llama.cpp 系工具加载模型。操作动作:先确认模型的文件头和元数据,再确认推理工具版本是否支持该 GGUF 版本,最后确认量化类型与后端是否匹配。验证方式:加载时不报格式版本错误、元数据里的架构与分词器符合预期、短提示词能正常出词。风险边界:GGUF 不能从旧 .bin 反向转换,必须有原始权重才能重新导出;不同后端支持的 GGUF 版本和量化类型有差异,出问题先回退到未量化版本验证链路。
先确认当前场景和目标
先要判断你手上这件事属于哪一种,否则容易在“格式”和“量化”之间绕圈。通常可以按三类场景区分:第一类是只想把现成模型跑起来,这时你关心的是推理工具能不能读这个文件;第二类是要自己从 Hugging Face 权重转成 GGUF 或换量化档位,这时你关心的是转换脚本和原始权重是否齐全;第三类是从旧项目迁移,手上是早期的 .bin 文件,这时你关心的是有没有必要和能不能重新转换。
需要先确认的信息有四项:文件的实际格式(看文件头而不是看后缀)、模型的架构和参数量、当前的推理后端及其版本、以及是否保留了原始权重(safetensors 或 PyTorch bin)。如果第四项不成立,后面所有“转换”动作都做不了,只能沿用旧版工具去加载旧文件。另外要明确目标:是为了在有限内存里跑起来,还是为了统一文件管理。前者主要靠量化档位解决,后者才需要关心容器格式本身。
按这个顺序处理
建议按“认文件 → 读元数据 → 对工具版本 → 再决定转换或量化”的顺序走,不要一上来就换工具。
- 确认文件真实格式。看文件头四个字节,GGUF 文件通常是 ASCII 的 GGUF 魔数;旧 GGML 系列的魔数标识与之不同,且不一定以可读字符呈现。这一步能避免把 .bin 改名成 .gguf 后反复报错。
- 读出元数据。用 llama.cpp 自带的查看工具或 Python 的 gguf 读取库打印字段,重点看 architecture、量化类型、上下文长度、tokenizer 模型类型、chat template 是否存在。
- 核对工具版本。GGUF 格式本身有版本号,老版推理工具读新版文件时可能直接拒绝加载。先确认你用的 llama.cpp、llama-cpp-python 或封装工具是否在近期维护范围内,必要时升级工具而不是降级文件。
- 需要转换时从原始权重出发。用仓库提供的 HF 转 GGUF 脚本导出,再用量化工具压到目标档位。脚本名字和参数在不同版本里有改动,动手前看仓库当前的 README 说明,不要照抄旧教程。
- 旧 .bin 文件单独处理。如果没有原始权重,就只能找仍然支持旧格式的旧版本工具来加载;如果有原始权重,建议直接重新导出 GGUF,不要在旧格式上继续投入。
# 1) 看文件头,判断是不是 GGUF
head -c 4 model.gguf | xxd

# 2) 打印元数据(字段名以实际库版本为准,可按需替换)
python -c "
from gguf import GGUFReader
r = GGUFReader('model.gguf')
for k in list(r.fields)[:20]:
    print(k)
"

# 3) 最小推理验证(命令名与参数随版本不同,以本地 --help 为准)
llama-cli -m model.gguf -p "你好" -n 64
改完后怎么验证
验证分三层,逐层往下走,不要跳步。第一层是加载层:推理工具启动时不再出现未知魔数、不支持的文件版本、无法解析的张量类型这类报错,并能在日志里打印出模型架构和层数。第二层是元数据层:architecture 与模型来源一致,量化类型与你选择的档位一致,tokenizer 与 chat template 字段存在,上下文长度不是异常值。第三层是输出层:用一段短提示词跑一次,输出连贯、可读,中文不出现乱码或整段空白,多轮对话时角色标记没有串位。
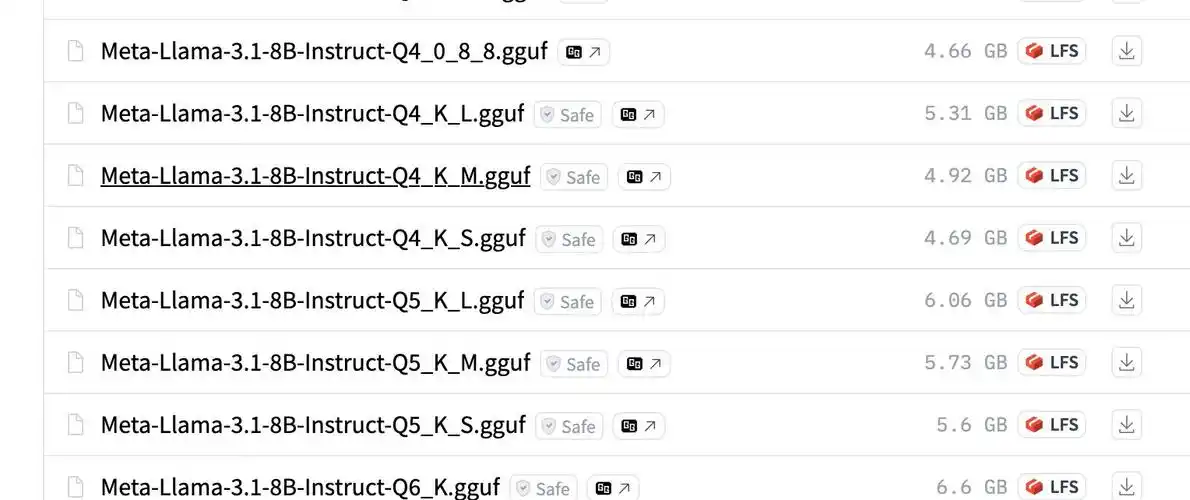
如果做过转换或量化,建议用同一个提示词对比转换前后的输出,观察语义是否明显跑偏,而不是只看能不能跑通。量化档位越低,输出波动越容易被察觉,这时宁可后退一档量化,也不要为了省内存把模型压到明显失真。验证阶段保留原始权重和旧工具版本,出现异常可以直接回退定位是格式问题还是量化问题。
容易忽略的边界
- GGUF 是容器格式,不是量化算法。同一个 .gguf 文件可能装的是未量化的权重,也可能是低比特量化权重,看到后缀相同不代表精度相同。
- “GGML 模型”这个说法不严谨。它通常指旧 .bin 文件,但 GGML 本身是计算库名;讨论时最好说明是“旧 GGML 文件格式”还是“GGML 库”。
- 后端支持范围不一致。llama.cpp 之外的各种封装、GUI、推理服务对 GGUF 版本和量化类型的支持程度不同,某些量化类型在特定 GPU 后端上支持不完整,可以先用 CPU 跑通再切回 GPU。
- 不能从旧格式反向还原。没有原始权重时,.bin 无法直接“升级”成 GGUF,只能靠旧工具继续加载,或者重新下载原模型。
- 元数据缺失会导致怪现象。分词器或对话模板缺失时,模型能加载但输出格式异常,这种问题容易被误判成模型质量问题。
- 回退建议。链路不通时,先用未量化的 GGUF 跑通加载和推理,再逐步加量化和换后端;迁移旧项目时保留旧版工具环境,避免一次性切换导致两头都不可用。