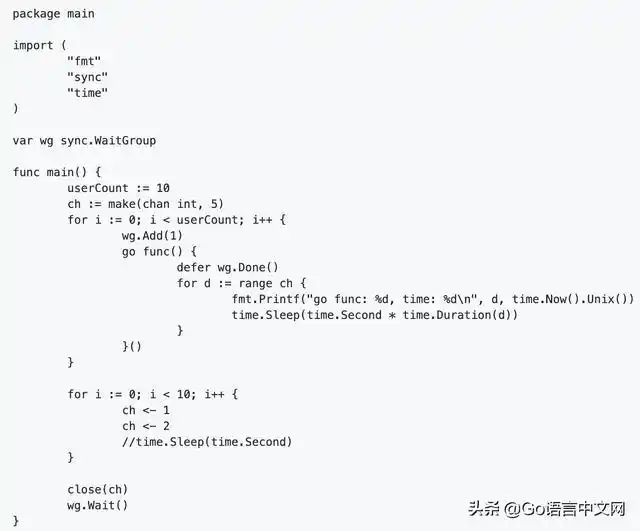
控制 goroutine 数量的核心做法,是把「提交任务」和「执行任务」之间加一层有界结构:固定数量的 worker 池,或者带容量的信号量。这样上游提交得再快,也只能排到队列边界为止,goroutine 不会随任务量无上限增长。动手前先分清任务是 CPU 密集还是 IO 等待,前者并发上限通常参考 GOMAXPROCS,后者要看下游连接池和接口配额能承受多少,而不是凭感觉把并发数设成一个整数。
适用场景:批量任务、循环里直接 go、请求处理里再起 goroutine 这几类写法,都值得先确认 goroutine 峰值来源。操作动作:把不受限的 go 改成固定 worker 池或带缓冲信号量,并给每个任务加 context 与 recover。验证方式:用 runtime.NumGoroutine 或 pprof goroutine 对比任务前后的数量,确认任务结束后能回落到基线。风险边界:信号量只限制同时执行数,不限制 goroutine 总数;队列深度和并发上限要结合下游连接池确认,不能只调大。
先确认当前场景和目标
先确认四件事,再决定用哪种写法。第一,任务总量是否已知:一次性切片可以直接切分,流式或不固定长度就得靠队列做背压。第二,任务是否需要收集结果和错误:需要汇总错误时,worker 池要自己加错误 channel,或者改用 errgroup。第三,单个任务失败后是跳过、重试还是整体取消,这决定了 context 怎么传。第四,下游到底允许多少并发,数据库连接池上限、HTTP 客户端连接数、第三方接口配额,这些通常比 CPU 核数更早成为瓶颈。
同时先把现状量化一下,避免凭印象判断。可以在任务开始前后打印 runtime.NumGoroutine(),也可以在服务里挂上 net/http/pprof,用 go tool pprof http://127.0.0.1:6060/debug/pprof/goroutine 看堆积在哪个调用栈。如果 goroutine 峰值跟任务量近似线性增长,说明确实没有做数量控制;如果峰值稳定但任务很慢,瓶颈更可能在下游而不是并发度。
按这个顺序处理
第一步,搜索代码里所有裸的 go func 和循环内的 go,标记出没有数量上限的位置。任务量大且可以排队时,优先换成固定 worker 池,队列容量就是背压点:
jobs := make(chan Job, 128)
var wg sync.WaitGroup
for i := 0; i < 8; i++ {
    wg.Add(1)
    go func() {
        defer wg.Done()
        for j := range jobs {
            run(j) // run 内部自己 defer recover
        }
    }()
}
for _, j := range allJobs {
    jobs <- j
}
close(jobs)
wg.Wait()
第二步,如果任务必须保持“一个任务一个 goroutine”的语义,比如每个任务要独立等待长连接返回,可以用带缓冲 channel 当信号量。注意这种写法限制的只是同时执行的个数,goroutine 本身仍然是每任务一个,任务量很大时还是要回到 worker 池:
sem := make(chan struct{}, 8)
var wg sync.WaitGroup
for _, j := range jobs {
    j := j
    wg.Add(1)
    go func() {
        defer wg.Done()
        sem <- struct{}{}
        defer func() { <-sem }()
        run(j)
    }()
}
wg.Wait()
第三步,如果更在意错误传播和取消,用 errgroup 并设置并发上限,把 context 一路传进任务内部,让超时和取消能真正中断阻塞调用:
g, ctx := errgroup.WithContext(context.Background())
g.SetLimit(8)
for _, j := range jobs {
    j := j
    g.Go(func() error {
        return runWithContext(ctx, j)
    })
}
if err := g.Wait(); err != nil {
    log.Printf("batch failed: %v", err)
}
第四步,补齐三件容易漏的事:每个任务入口加 defer recover(),避免单个任务 panic 把整个进程带下去;队列满了以后要么阻塞提交,要么明确拒绝并记录,别用丢弃又不打日志的方式;给整批任务加一个总超时,防止个别任务卡住导致 wg.Wait 永远不返回。
改完后怎么验证
验证分三层。第一层看数量:在任务开始前记录一次 runtime.NumGoroutine(),任务全部结束后再取一次,中间留出短暂时间让 goroutine 退出;如果结束后的数字明显高于开始前,说明有 goroutine 卡在 channel 或锁上没有退出。第二层看调用栈:任务运行中用 pprof goroutine 抓一次,确认同时处于业务执行的 goroutine 数量接近设定的上限,而不是几千个停在 chan send 或 IO wait。第三层看行为:人为把下游调慢或注入超时,观察提交端是否被队列挡住,而不是继续无限起 goroutine;取消 context 后,任务是否在合理时间内全部返回。
另外建议在测试里用 go test -race 跑一遍并发路径,配合 -count 多跑几轮,看看有没有偶发的阻塞或者数据竞争。如果改动前后都用同一份压测输入,也可以对比总耗时和内存占用,判断并发上限设得偏高还是偏低,但这类对比只在同一台机器、同一份数据下才有参考意义。
容易忽略的边界
并发上限不能只看 CPU。worker 数量设得比下游连接池上限还大时,多出来的 goroutine 只是在等连接,通常不会更快,反而拉长排队时间。队列容量也不是越大越好,容量过大等于把背压推迟到内存耗尽的时候才出现。
版本和语法上要确认两点:errgroup 的 SetLimit 需要较新的 x/sync 依赖,升级前先看 go.mod 里的版本是否支持;循环变量捕获的行为与语言版本有关,习惯性写 j := j 更稳妥,不依赖版本默认行为。panic 处理也要注意,worker 池里某个任务 panic 未被 recover 时,整个进程会退出,不是只死一个 goroutine。
如果当前环境还不能改代码结构,可以先在调用入口加一层限流或者排队,把并发压住作为过渡,但这只是把问题挪到上游,任务量继续增长时仍然需要回到 worker 池或信号量的写法。改完之后保留原来的超时和重试配置,不要因为加了并发上限就顺手放大这些参数。